xAI a publié Grok 4.7 le 21 septembre 2026. Le modèle est annoncé comme la version la plus capable de la maison pour le code et le travail de connaissance. Il est disponible le jour même dans Cursor, Grok Build et via l’API grok-4.7, au même tarif de base que Grok 4.6. L’annonce officielle est sur x.ai/news/grok-4-7, avec les notes développeur dans les release notes et la grille modèles / prix sur docs.x.ai.
Le pitch vendor est clair : travailler plus longtemps sur les tâches difficiles, mieux vérifier ses propres réponses, et rester « highly competitive » face à GPT-5.6 Sol et Claude Fable 5.1, pour un prix nettement plus bas. Les chiffres ci-dessous sont ceux publiés par xAI le jour du lancement. Ce sont des scores vendor, à croiser avec vos propres évaluations.
Ce que xAI change dans Grok 4.7
Selon le billet, Grok 4.7 repose sur un nouveau modèle de base plus large que Grok 4.6. L’entraînement a prolongé le run de reinforcement learning sur un mix de tâches plus dures, avec un poids fort sur des problèmes qui prennent plusieurs heures. xAI met en avant une meilleure vérification interne, une gestion de contexte plus solide, et un entraînement natif sur le harness Grok Bot pour le travail conversationnel et le knowledge work.
Côté produit API, le modèle s’appelle grok-4.7. Contexte 500k tokens, entrée texte + image, sortie texte seule, pas de limite de sortie texte annoncée. Effort de raisonnement : low, medium, high (défaut) et xhigh. Sur l’API Responses, grok-4.7 renvoie toujours reasoning.encrypted_content. Une variante Grok 4.7 Fast (environ 2× le débit de tokens, 2× le prix) est servie via Cursor et Grok Build, pas sur l’API publique xAI. Knowledge cutoff annoncé : mai 2026.
Benchmarks : où Grok 4.7 se place face à GPT-5.6 Sol et Fable 5.1
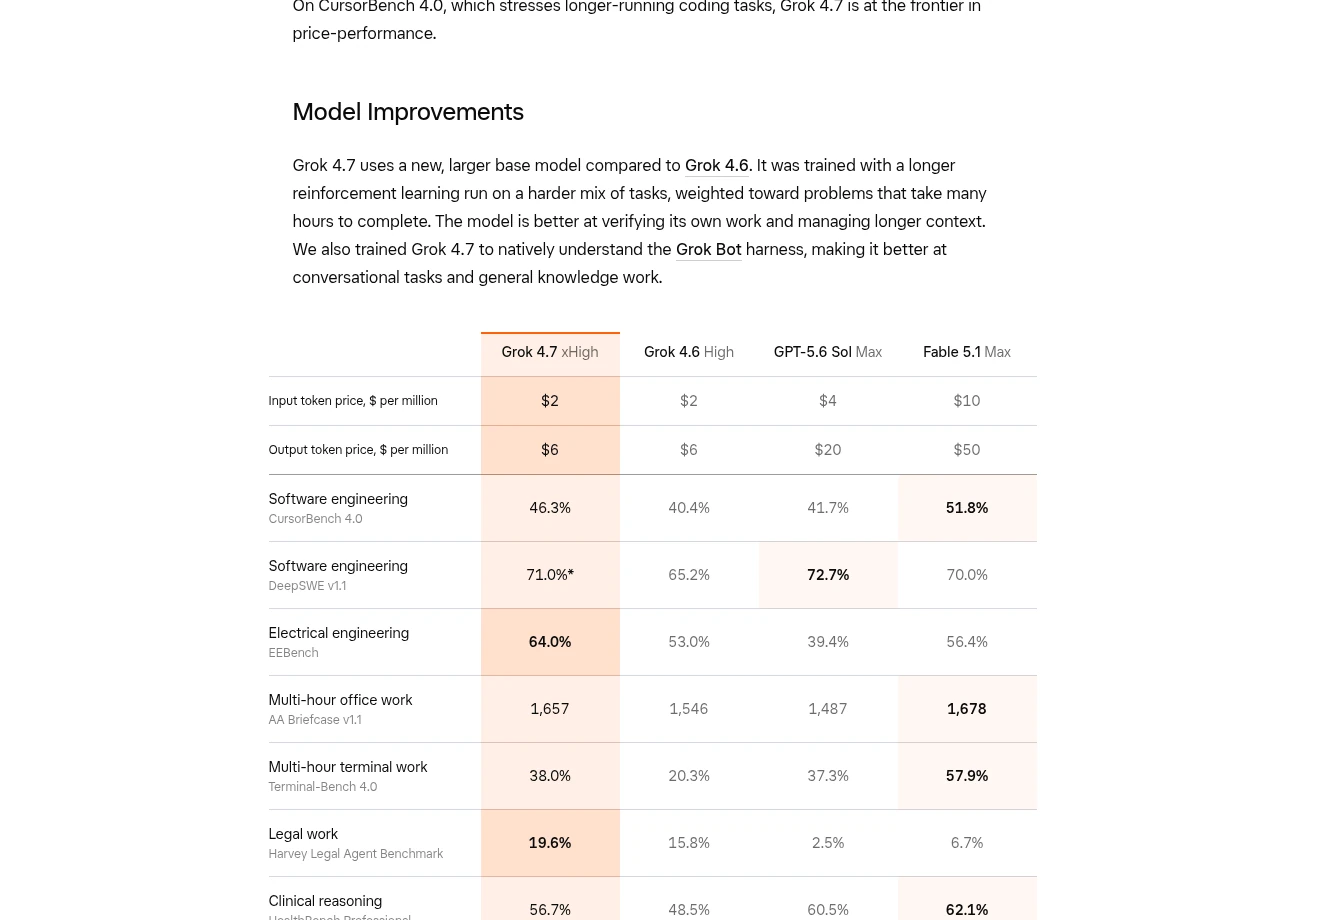
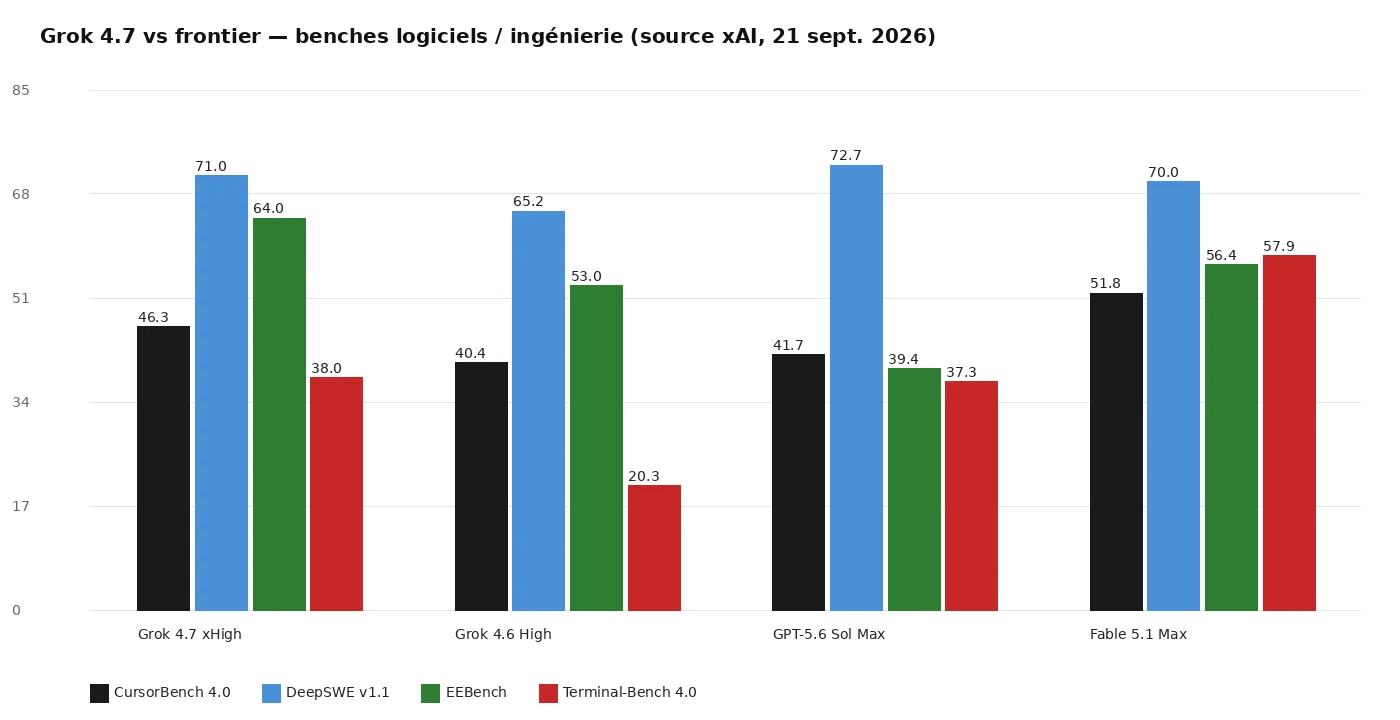
Le tableau officiel compare Grok 4.7 xHigh, Grok 4.6 High, GPT-5.6 Sol Max et Fable 5.1 Max. Synthèse des lignes clés :
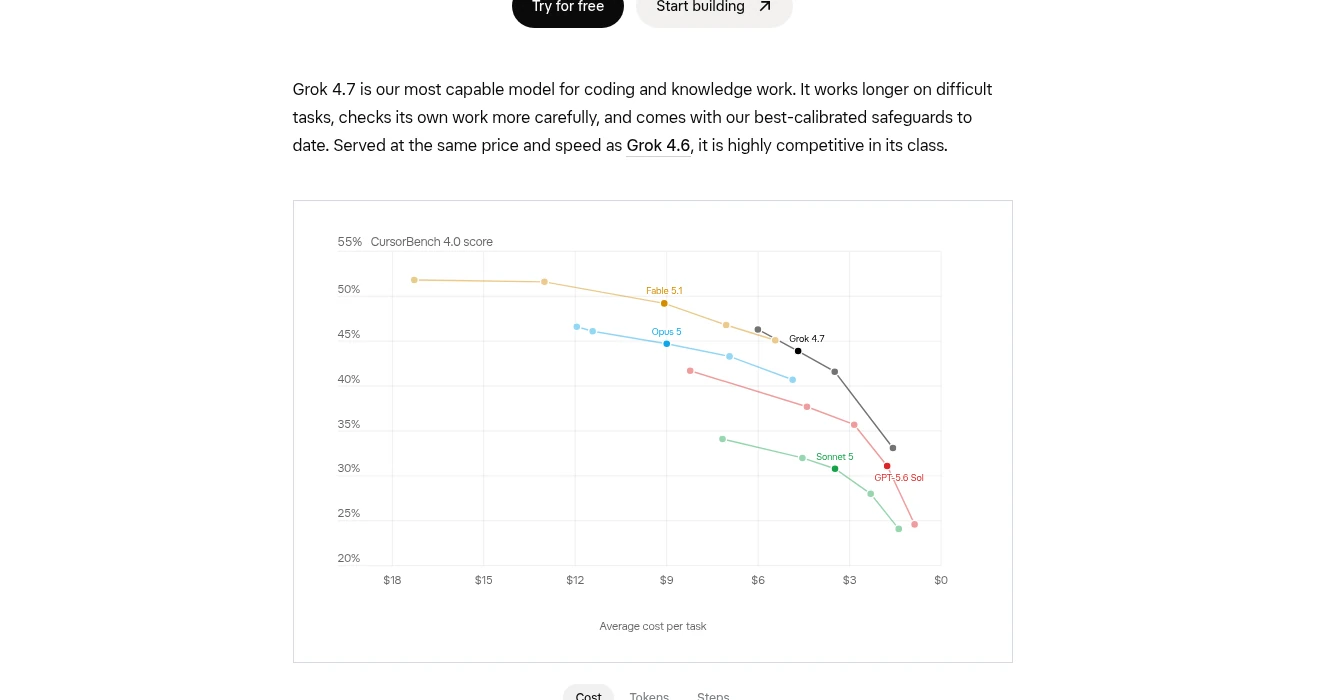
- CursorBench 4.0 (agents de code longue durée) : Grok 4.7 à 46,3 %, devant GPT-5.6 Sol (41,7 %) et Grok 4.6 (40,4 %), derrière Fable 5.1 (51,8 %). Sur la courbe coût / score, xAI le place à la frontière prix-performance.
- DeepSWE v1.1 : Grok 4.7 à 71,0 % en high effort (astérisque vendor), très proche de Fable 5.1 (70,0 %) et juste sous GPT-5.6 Sol (72,7 %). Grok 4.6 était à 65,2 %.
- EEBench (ingénierie électrique) : Grok 4.7 en tête à 64,0 %, devant Fable 5.1 (56,4 %) et loin devant GPT-5.6 Sol (39,4 %).
- Terminal-Bench 4.0 : Grok 4.7 à 38,0 % (quasi Sol à 37,3 %), nettement au-dessus de Grok 4.6 (20,3 %), mais loin de Fable 5.1 (57,9 %).
- AA Briefcase v1.1 (bureau multi-heures) : 1 657 pour Grok 4.7, entre Sol (1 487) et Fable (1 678).
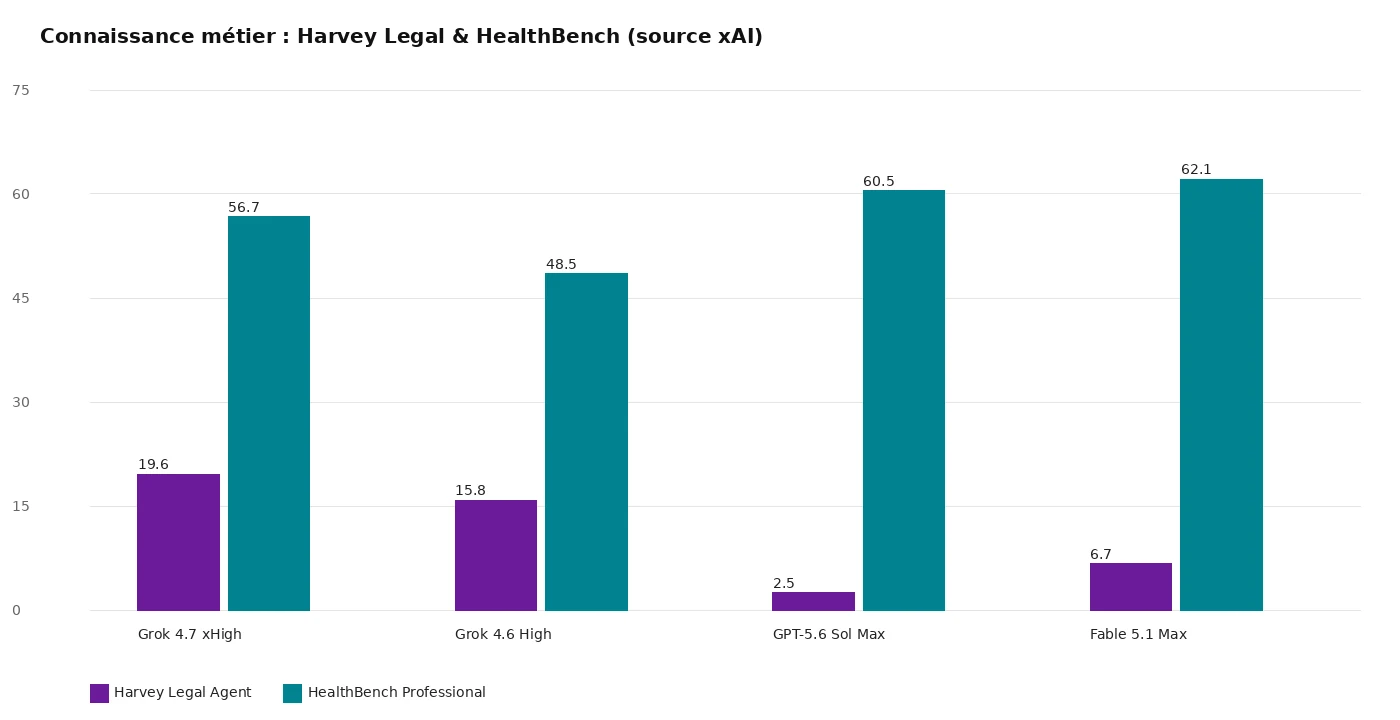
- Harvey Legal Agent : Grok 4.7 en tête à 19,6 %, devant Grok 4.6 (15,8 %), Fable (6,7 %) et Sol (2,5 %).
- HealthBench Professional : 56,7 % pour Grok 4.7, derrière Sol (60,5 %) et Fable (62,1 %), devant Grok 4.6 (48,5 %).
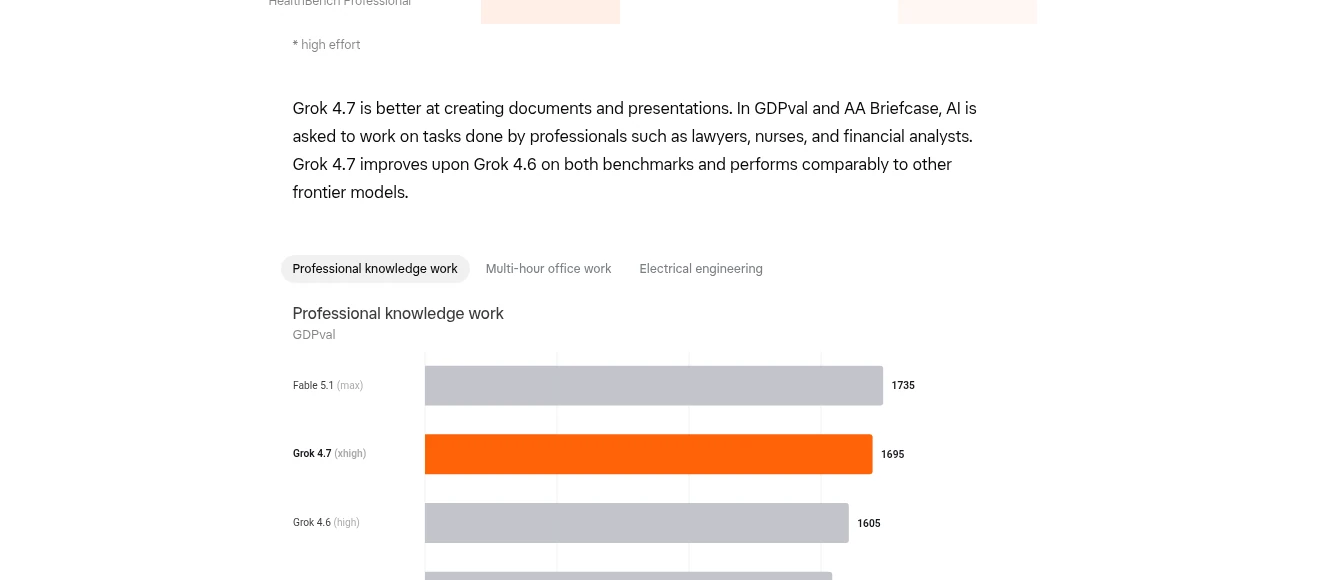
Sur GDPval (travail de connaissance professionnelle), xAI publie Fable 5.1 max à 1 735, Grok 4.7 xhigh à 1 695, Grok 4.6 high à 1 605 et GPT-6 Astra max à 1 542. Autrement dit : Grok 4.7 se rapproche de Fable sur ce barème Elo, tout en restant moins cher à l’API.
Prix API, disponibilité et variante Fast
Tarif public annoncé pour grok-4.7 (identique à Grok 4.6 sur la grille courte) :
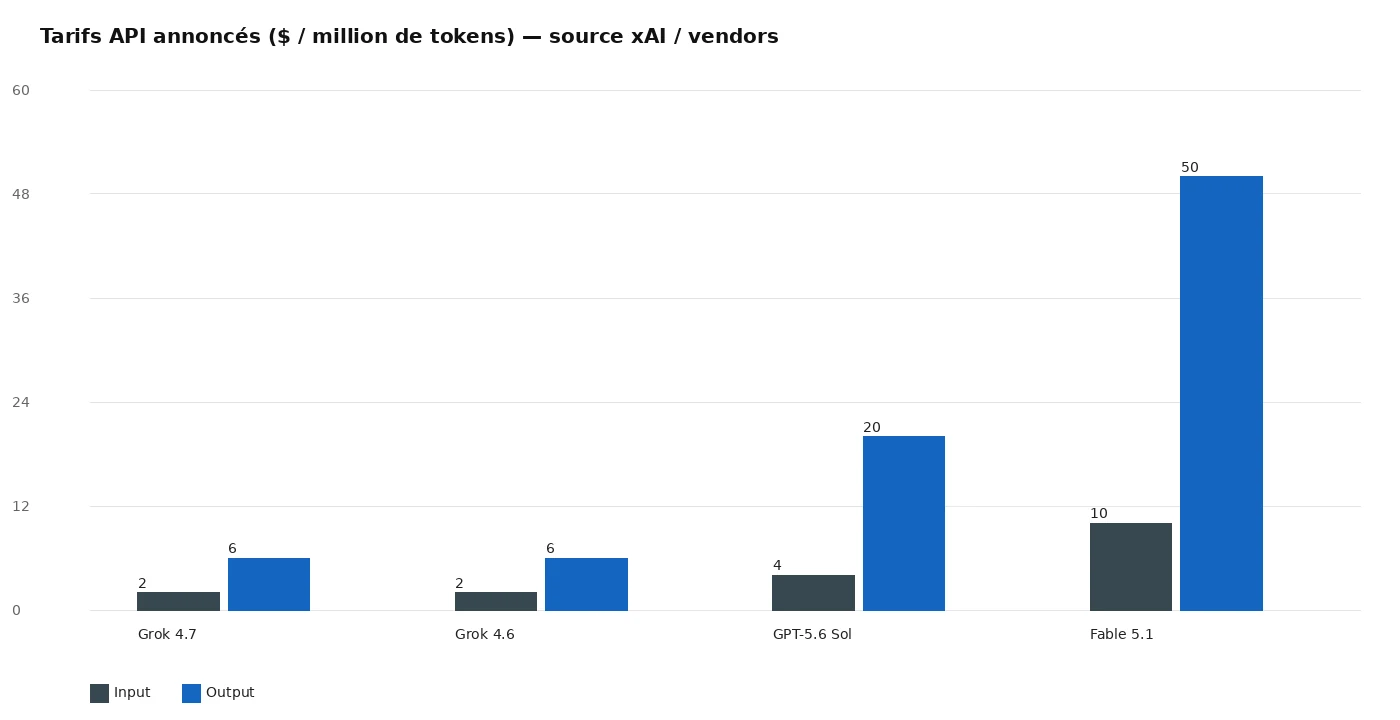
- Prompt < 200k tokens : 2 $ / M input, 0,50 $ cached input, 6 $ / M output.
- Prompt ≥ 200k tokens : 4 $ / M input, 1 $ cached, 12 $ / M output (tarif appliqué à toute la requête).
En face, le tableau vendor place GPT-5.6 Sol Max à 4 $ / 20 $ et Fable 5.1 Max à 10 $ / 50 $ le million (input / output). Le message marketing « twice as fast, at half the price of comparable models » vise surtout ce rapport coût / capacité, pas une égalité ligne à ligne sur tous les benches.
Disponibilité le jour J : Cursor, Grok Build, API Grok, harnesses de coding tiers, routeurs de modèles et plateformes cloud. xAI invite aussi à tester via x.ai/build et la console API.
Sécurité, cybersécurité et contexte du retard
xAI dit avoir reconstruit la pile de garde-fous. Sur le benchmark biosécurité LatchBio, Grok 4.7 est annoncé à 62,4 %. Sur HackerBench v0.3 (tâches cyber dual-use), le vendor revendique le meilleur profil sécurité de sa gamme, avec seulement 3,3 % des prompts risqués qui passent, tout en bloquant peu le travail de sécurité légitime. Un accès red-team invite-only est ouvert à des partenaires cybersécurité.
À noter pour le calendrier : Elon Musk avait d’abord visé une sortie autour du 12 septembre, puis annoncé un retard de « quelques jours » pour recalibrer le RL (abandon trop tôt sur certaines tâches dures, auto-vérification insuffisante). Le modèle public est finalement arrivé le 21 septembre 2026, avec ces axes explicitement mis en avant dans le billet.
En pratique, pour un lecteur qui compare les frontier 2026 : Grok 4.7 n’écrase pas Fable 5.1 sur CursorBench ni Terminal-Bench 4.0, reste dans le peloton DeepSWE, sort du lot sur EEBench et Harvey Legal, et conserve le ticket d’entrée bas à 2 $ / 6 $. C’est surtout un argument prix-performance et agent longue durée, pas un sweep complet des leaderboards. Sources : Introducing Grok 4.7, Models & Pricing, Release Notes.
