Anthropic a publié Claude Opus 5.5 le 22 septembre 2026. C’est le premier modèle de la famille Claude 5.5. Sur la plupart des tâches, la maison le place au niveau de Claude Fable 5.1, pour un coût d’exécution annoncé environ 40 % inférieur à Opus 5 sur des workloads typiques. L’annonce est sur anthropic.com/claude-opus-5-5, avec les fiches techniques sur platform.claude.com et le compte @claudeai.
Disponible le jour J sur la plateforme Claude, Amazon Web Services, Google Cloud et Microsoft Azure. Identifiant API : claude-opus-5-5. Contexte 1 M tokens, sortie max 128 K, thinking adaptatif always-on (effort par défaut medium), knowledge cutoff juin 2026. Anthropic dit aussi que la sortie est environ 30 % plus rapide qu’Opus 5, que les plafonds d’usage Pro / Max / Team ont été relevés, et qu’un reset de rate-limit peut désormais être stocké puis consommé plus tard.
4 $ / 20 $ le million, cache à 0,20 $, Fast mode à 2,5×
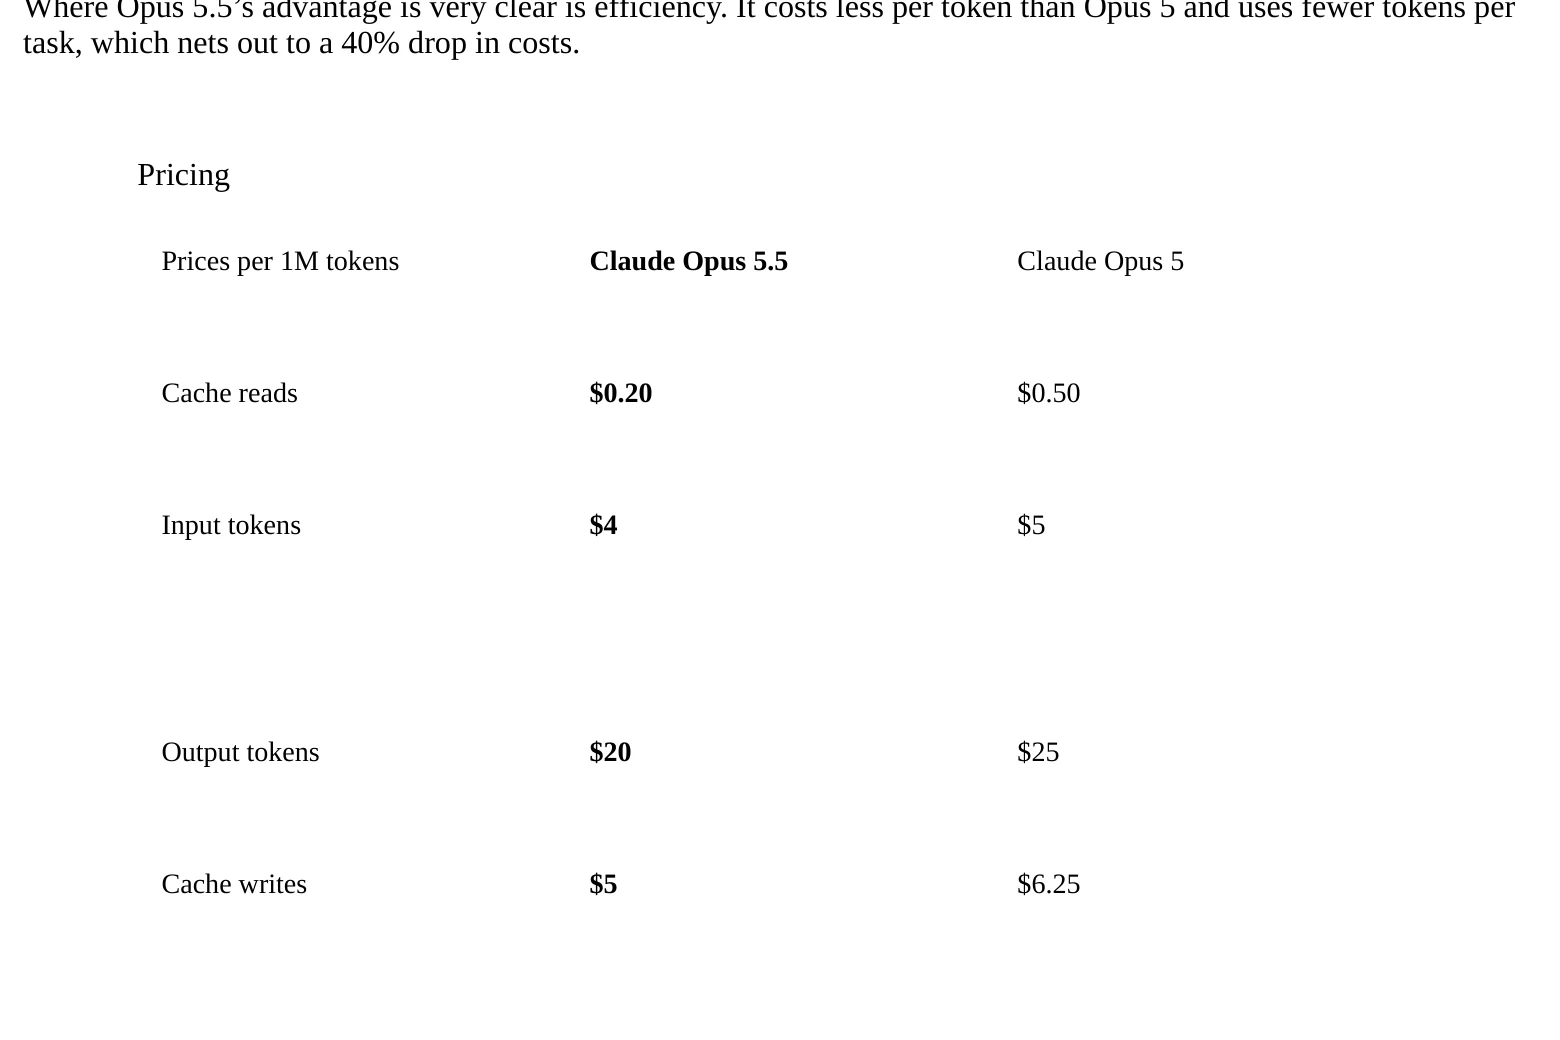
Grille API annoncée (par million de tokens), face à Opus 5 :
- Input / output : 4 $ / 20 $ (Opus 5 : 5 $ / 25 $)
- Cache reads : 0,20 $ (Opus 5 : 0,50 $)
- Cache writes : 5 $ (Opus 5 : 6,25 $)
Le « Fast mode », disponible dans Claude Code et sur la Claude Platform, pousse jusqu’à environ 2,5× la vitesse, à 8 $ / 40 $ le million (input / output). Anthropic insiste sur le fait que le modèle consomme aussi moins de tokens par tâche : le −40 % annoncé combine donc prix unitaire et volume.
Côté coding, Anthropic met en avant des jobs longs : audit / correctifs sur une base de 200 000 lignes en moins de trois heures (contre plus de 20 h et 2,5× plus de tokens pour Opus 5, selon le vendor), ou une réécriture HAProxy C→Rust passée en 9,5 h contre 12 h pour Fable 5.1, à −51 % de coût. Ce sont des anecdotes d’early testers et de tests internes, pas des benches publics.
Pour situer le ticket : Fable 5.1 reste nettement plus cher (10 $ / 50 $ sur la grille modèles Anthropic). En face, le tableau vendor d’Anthropic place GPT-5.6 Sol à 4 $ / 20 $ sur certaines lignes de benches coût, et Grok 4.7 reste à 2 $ / 6 $ sous 200k tokens d’après l’annonce xAI du 21 septembre. Opus 5.5 n’est pas le moins cher du marché : il vise surtout le rapport score / coût côté coding agentique et knowledge work.
Terminal-Bench à 66,4 %, CursorBench à 57,8 %, avec un bémol
Les scores publiés (max effort sauf note, thinking adaptatif) mettent Opus 5.5 en tête de plusieurs barèmes Anthropic :
- Terminal-Bench 4.0 : 66,4 % (Fable 5.1 55,8 %, Opus 5 52,3 %, GPT-6 Astra 57,9 %, GPT-5.6 Sol 37,3 %). Pour Terminal-Bench, Anthropic précise un effort
xhighcôté Opus 5.5 et high côté Astra. - FrontierCode v1.1 (main) : 54,4 % (Fable 50,3 %, Opus 5 48,0 %, Astra 53,3 %, Sol 47,5 %).
- CursorBench 4.0 : 57,8 % (Fable 51,8 %, Opus 5 46,6 %, Sol 41,7 %).
- GDPval-AA v2.1 : 1846 Elo (Fable 1735, Opus 5 1708, Astra 1542, Sol 1588).
- AutomationBench : 40,0 % (Astra 41,4 % reste devant ; Fable 31,4 %, Opus 5 26,9 %, Sol 28,8 %).
- HLE with tools : 67,7 % ; Terminal-Bench-Science 0.1 : 58,7 % (Astra 64,6 %) ; OSWorld 2.0 : 81,8 % partial ; Chartography : 89,0 % with tools.
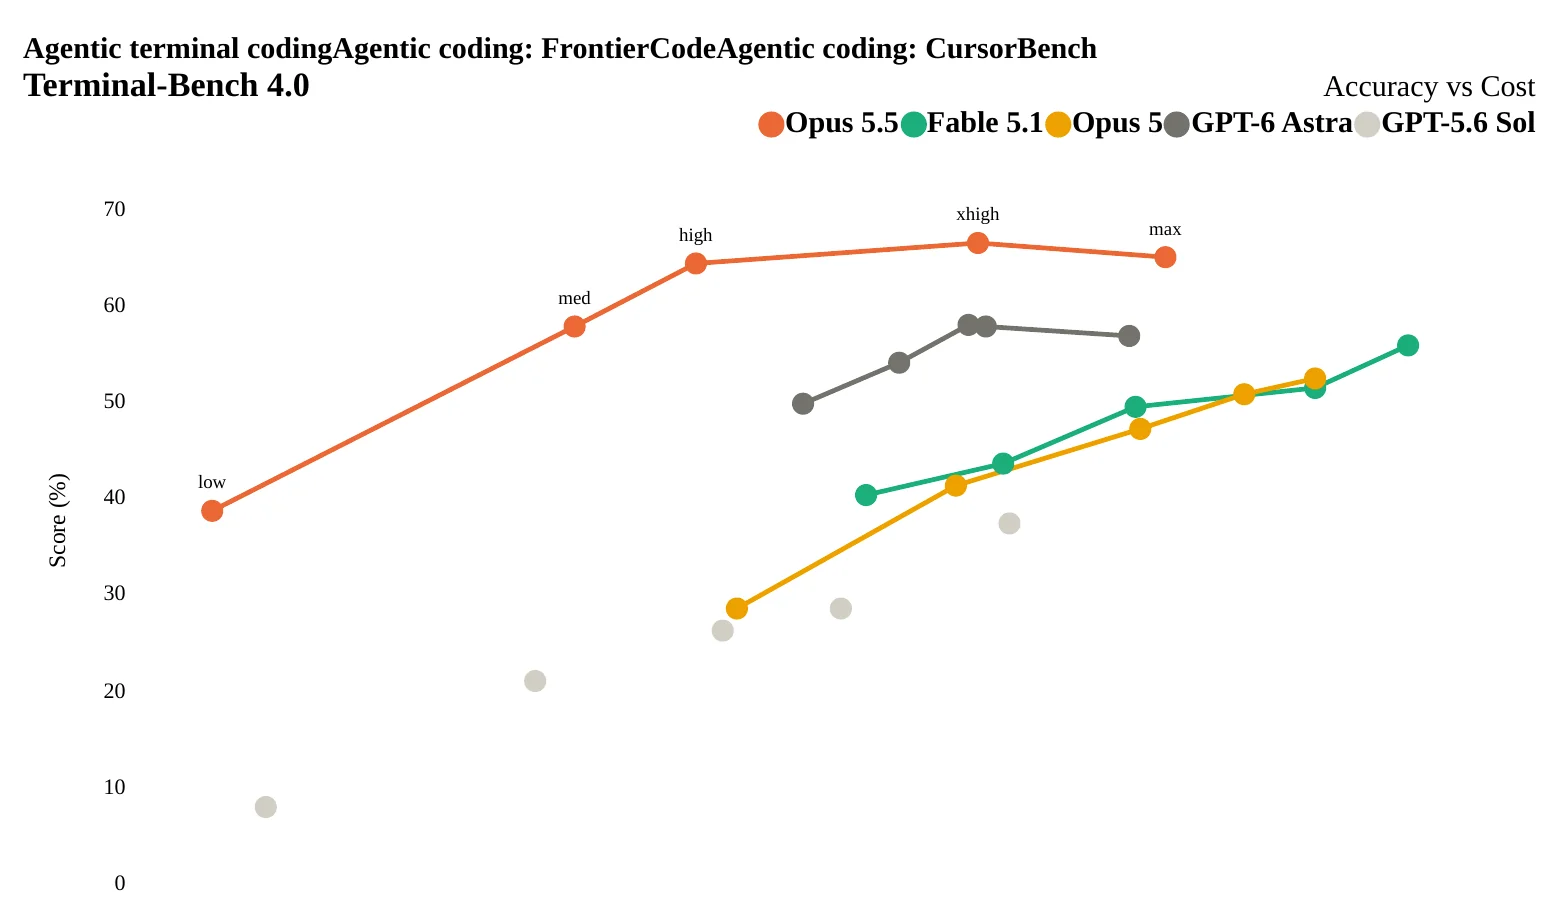
Deux nuances importantes dans le même billet. Premièrement, Anthropic écrit que l’écart réel face à Fable 5.1 est plus étroit que ces marges de scores. Deuxièmement, Opus 5.5 a été évalué avec ses safeguards de production : quand ils interviennent, les tâches cyber basculent vers Opus 4.8, et les tâches bio / frontier LLM development vers Opus 5, ce qui tire certains scores vers le bas. Sur AutomationBench (Zapier), les interventions sans fallback ont même été comptées comme échecs.
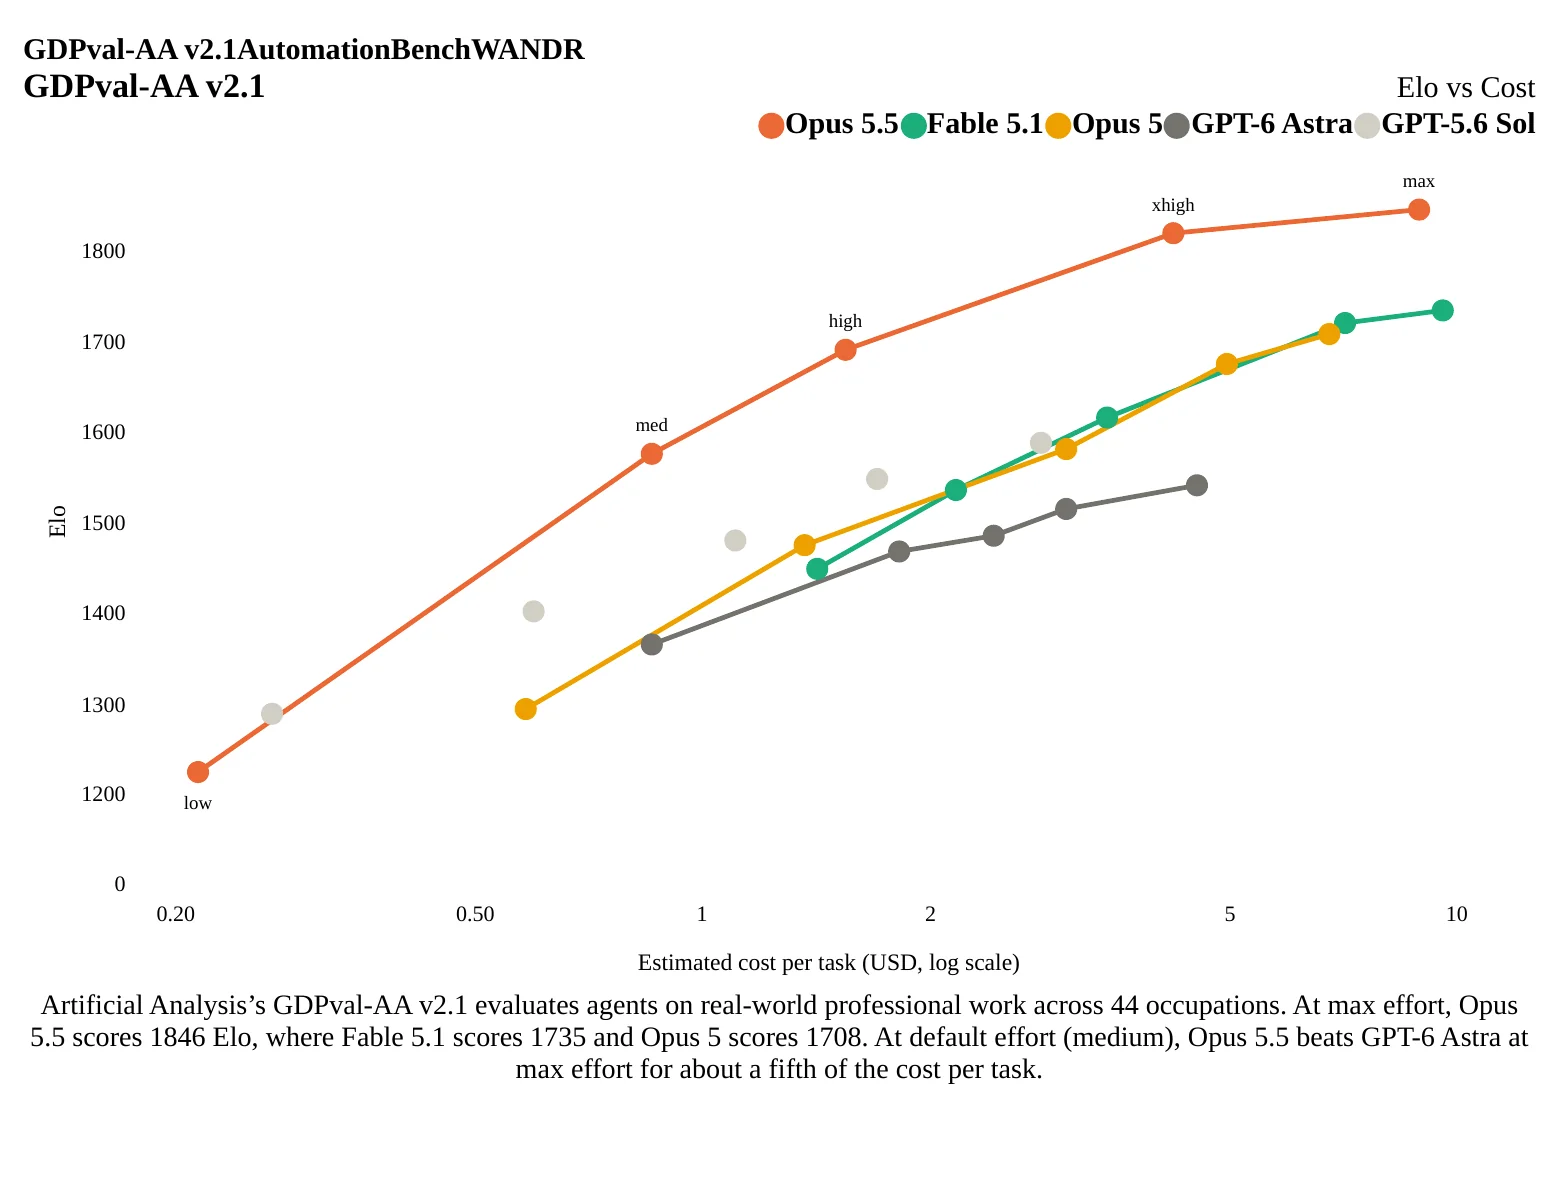
À titre de repère externe (chiffres xAI, pas Anthropic) : Grok 4.7 xHigh affichait 46,3 % sur CursorBench 4.0 et 38,0 % sur Terminal-Bench 4.0 le 21 septembre. Les protocoles et efforts ne sont pas alignés ligne à ligne ; la comparaison reste indicative.
Garde-fous type Fable, vérifications cyber et life sciences
Opus 5.5 reprend une classe de garde-fous proche de Fable 5.1 sur la cybersécurité, la biologie et la distillation (preserved thinking). Les organisations vetées peuvent déjà postuler au Life Sciences Verification Program ; le Cyber Verification Program doit être étendu dans les semaines à venir. Anthropic cite aussi des tests externes pré-lancement par Frontier Design et METR, et son meilleur score à ce jour sur l’audit comportemental automatisé maison.
Sur la distillation, le « preserved thinking » introduit avec Fable 5.1 s’applique aussi à Opus 5.5 pour les comptes API créés à partir du 31 août 2026 : l’édition du raisonnement précédent côté client est restreinte. Le mode thinking ne peut plus être désactivé. Anthropic signale enfin une disponibilité zero data retention comme sur les Opus précédents, et des mesures de watermarking liées à l’AI Act européen.
Claude Sonnet 5.5 et Claude Haiku 5.5 sont annoncés « dans les semaines à venir », avec une partie des mêmes axes performance / efficacité / sécurité.
En pratique, Opus 5.5 se présente comme l’Opus « quotidien » de la famille 5.5 : proche de Fable 5.1 sur beaucoup de benches vendor, nettement moins cher qu’Opus 5 et que Fable, avec des garde-fous qui réduisent volontairement certains scores. À croiser avec vos propres evals avant de basculer une flotte d’agents. Sources : Introducing Claude Opus 5.5, Models overview, Opus 5.5 overview, tweet @claudeai.
