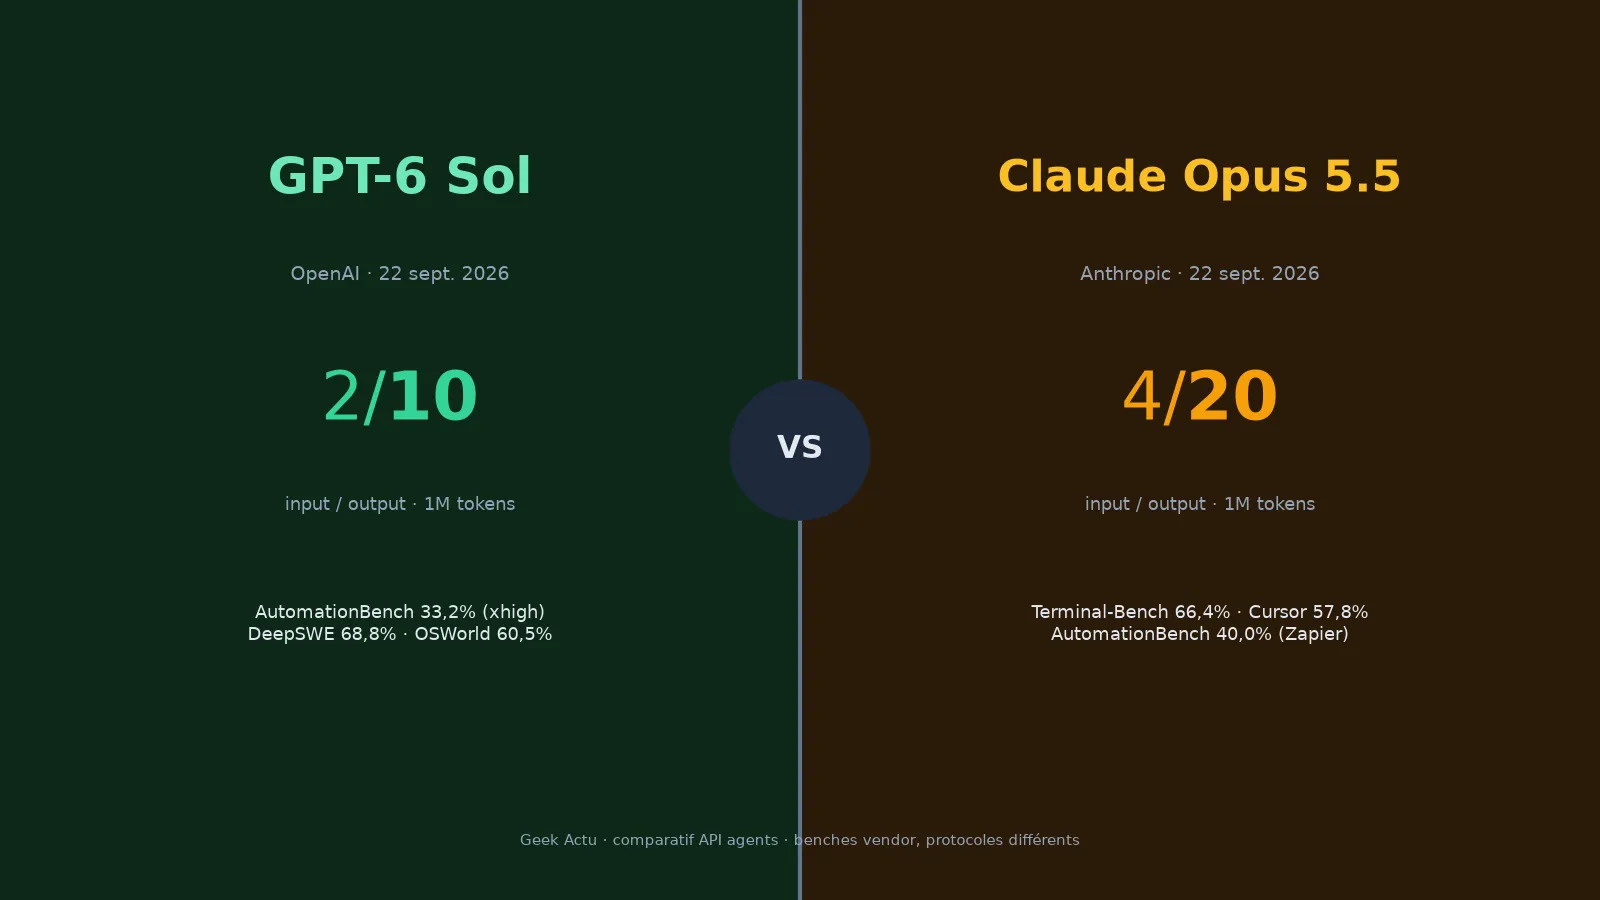
Le 22 septembre 2026, OpenAI sort GPT-6 Sol à 2 $ / 10 $ le million de tokens, le même jour qu’Anthropic publie Claude Opus 5.5 à 4 $ / 20 $. Sur le papier, Sol est environ deux fois moins cher à l’unité. Sur les benches, chacun des deux vendors compare son modèle à l’ancienne génération de l’autre. Il n’existe pas encore de grille head-to-head officielle GPT-6 Sol vs Opus 5.5 sur tous les barèmes. Ce dossier croise les chiffres des annonces OpenAI et Anthropic, avec nos billets déjà live sur Sol / Luna et Opus 5.5.
Identifiants API : gpt-6-sol et claude-opus-5-5. Effort par défaut medium des deux côtés. Sol est dans ChatGPT Work, Codex et l’API (pas encore le Chat classique). Opus 5.5 est annoncé sur toutes les plateformes Claude, AWS, Google Cloud et Azure.
Deux dollars contre quatre : la grille API face à face
Tarifs standard (par million de tokens), d’après la fiche gpt-6-sol et l’annonce Anthropic :
| GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|
| Input / Output | 2 $ / 10 $ | 4 $ / 20 $ |
| Cache reads | 0,20 $ | 0,20 $ |
| Cache writes | 2,50 $ | 5 $ |
| Fast mode | 2× les tarifs applicables (docs Sol) | 8 $ / 40 $, jusqu’à ~2,5× la vitesse |
| Contexte / sortie max | 1,05 M / 128 k | 1 M / 128 k |
| Knowledge cutoff | 20 avril 2026 | juin 2026 (fiche Geek Actu Opus) |
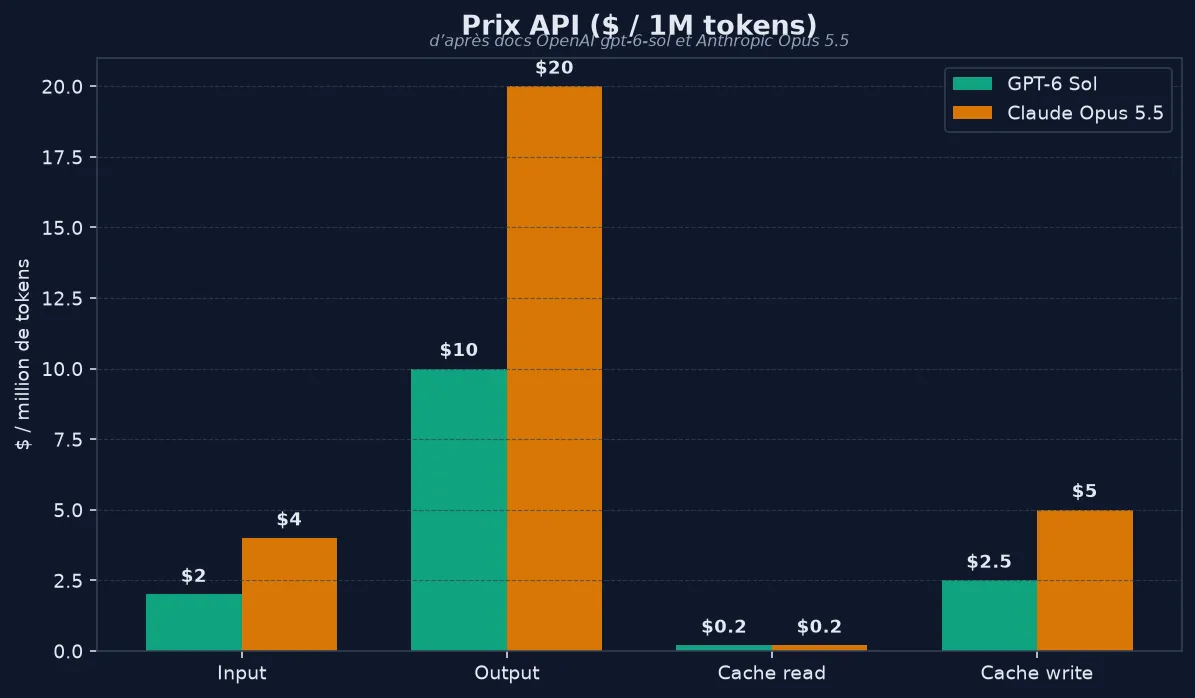
Sol applique une surcharge au-delà de 272 k tokens d’input (×2 input/cache, ×1,5 output pour toute la requête). Opus 5.5 met surtout en avant un coût de workload typique annoncé ~40 % sous Opus 5, grâce au prix unitaire et à une consommation de tokens plus basse. Les cache reads sont au même ticket (0,20 $) ; les cache writes restent deux fois moins chers chez OpenAI (2,50 $ vs 5 $). Pour un agent qui réutilise beaucoup de contexte, la densité token + le hit rate de cache compteront autant que le tarif unitaire.
OpenAI mesure Sol contre Opus 5, pas contre 5.5
Dans le billet OpenAI, GPT-6 Sol est placé face à Claude Opus 5 et Fable 5 / 5.1, pas face à Opus 5.5. C’est un proxy utile, pas un match du jour J.
- AutomationBench : Sol xhigh 33,2 % à 0,27 $/tâche, au-dessus d’Opus 5 max (26,9 %) à ~9 % du coût Sol, et au-dessus d’Astra low (30,3 %). Fable 5.1 est à 31,4 %, avec un coût sous-estimé (fallbacks Opus sur ~40 % des tâches non inclus).
- Agents’ Last Exam : Sol max 56,4 %, au-dessus du meilleur score Opus 5 de l’évaluation, avec environ −60 % de coût/tâche. Pas de chiffre Opus 5.5 dans ce tableau OpenAI.
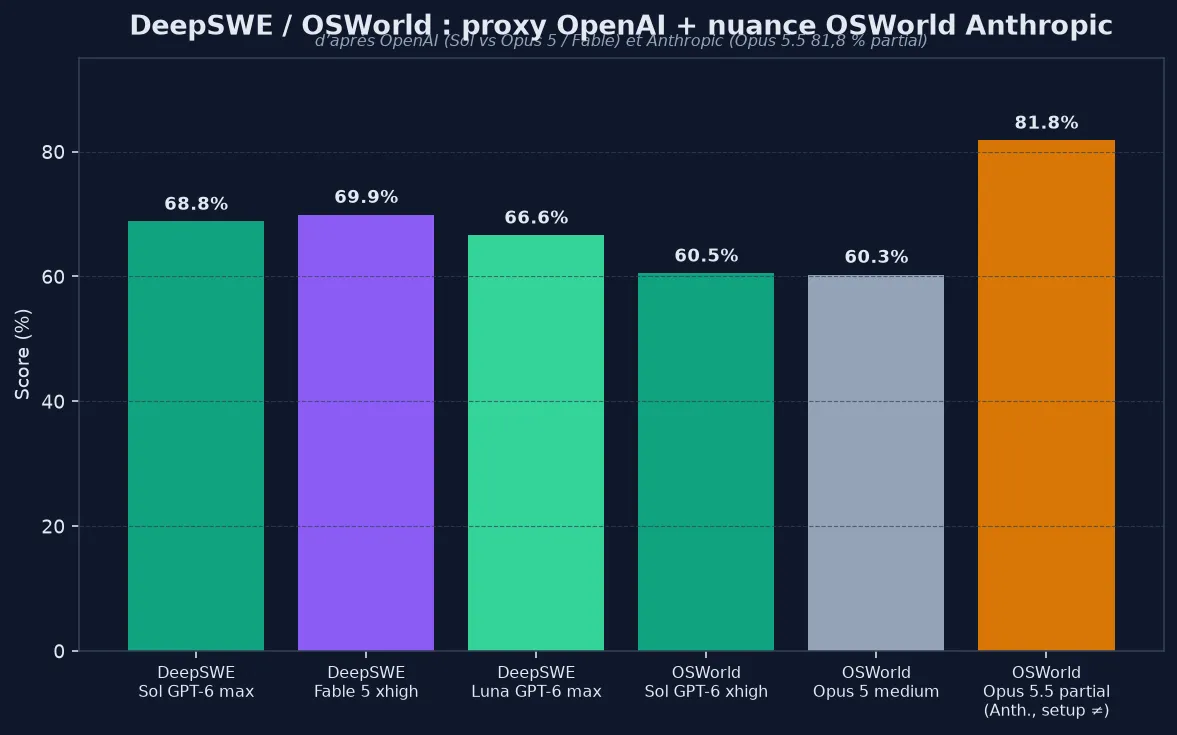
- DeepSWE v1.1 : Sol max 68,8 %, à 1,1 point de Fable 5 xhigh (69,9 %) pour ~−80 % de coût. Luna max 66,6 %. Pas d’Opus 5.5 dans le tableau OpenAI.
- FrontierCode 1.1 : OpenAI dit que Sol matche Fable 5.1 xhigh à bien moindre coût (sans publier le score Sol exact dans le texte).
- OSWorld 2.0 offline : Sol xhigh 60,5 % ≈ Opus 5 medium 60,3 % à ~−80 % de coût.
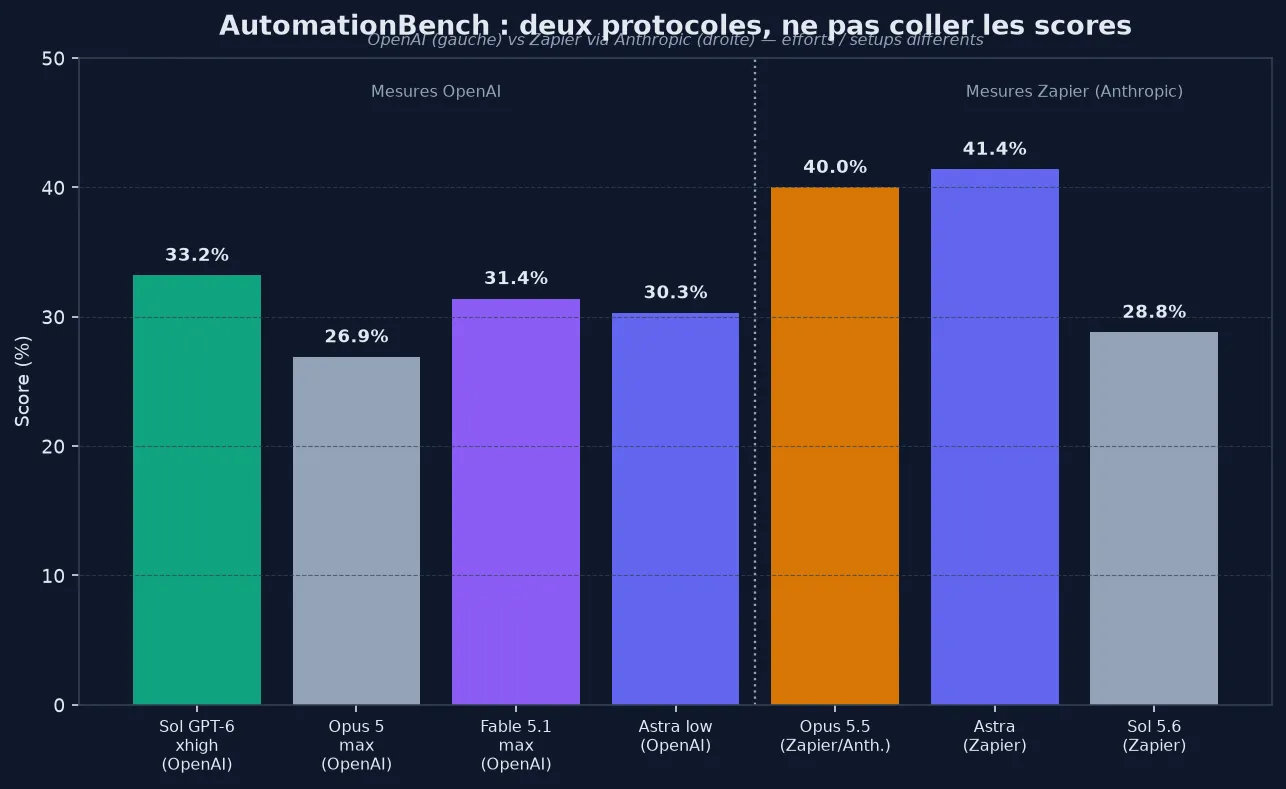
Côté Anthropic / Zapier, AutomationBench donne Opus 5.5 à 40,0 % et Astra à 41,4 %, avec GPT-5.6 Sol à 28,8 %. Anthropic précise que les interventions de safeguards sans fallback ont été comptées comme échecs, ce qui tire le score Opus 5.5 vers le bas par rapport à un usage réel. Conclusion journalistique : Sol GPT-6 bat clairement Opus 5 sur le protocole OpenAI à coût bas ; Opus 5.5 sort devant sur le protocole Zapier, sans Sol GPT-6 dans la grille.
Terminal-Bench à 66,4 % : le tableau Anthropic cite GPT-5.6 Sol
Sur le coding agentique, Anthropic publie une grille où la colonne Sol est explicitement GPT-5.6 Sol, pas GPT-6 Sol. Astra GPT-6 apparaît parfois. Lire ces lignes comme un plafond / plancher relatif, pas comme un KO Sol GPT-6.
| Bench (Anth., max effort sauf note) | Opus 5.5 | Fable 5.1 | Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % (xhigh) | 55,8 % | 57,9 % (high) | 37,3 % |
| FrontierCode v1.1 | 54,4 % | 50,3 % | 53,3 % | 47,5 % |
| CursorBench 4.0 | 57,8 % | 51,8 % | n/a | 41,7 % |
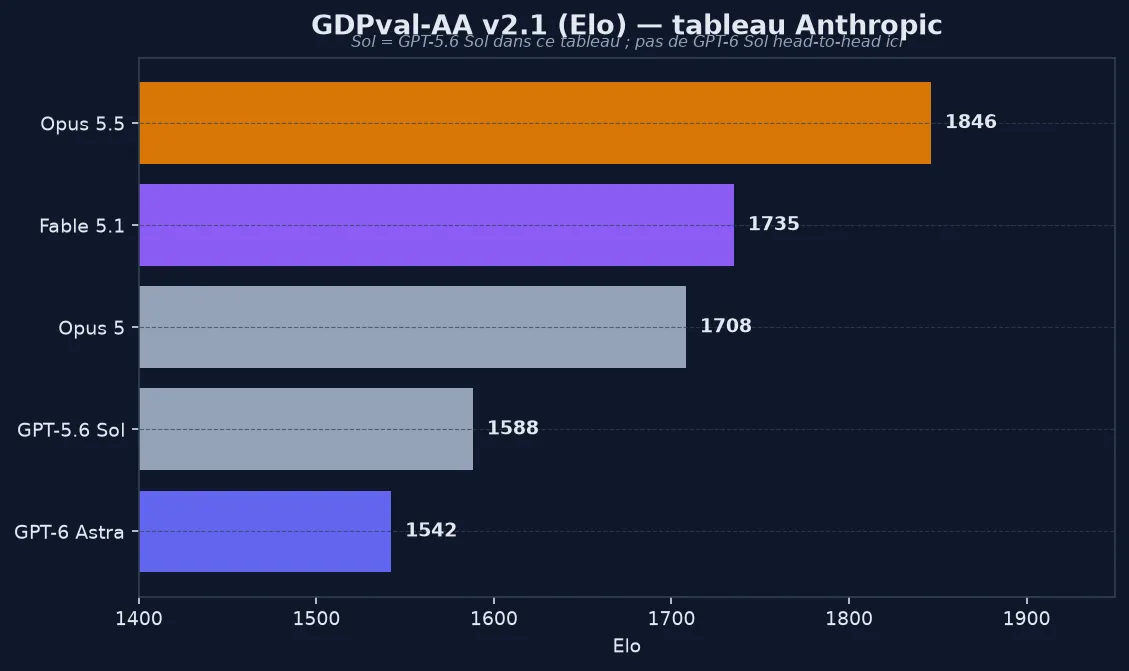
| GDPval-AA v2.1 (Elo) | 1846 | 1735 | 1542 | 1588 |
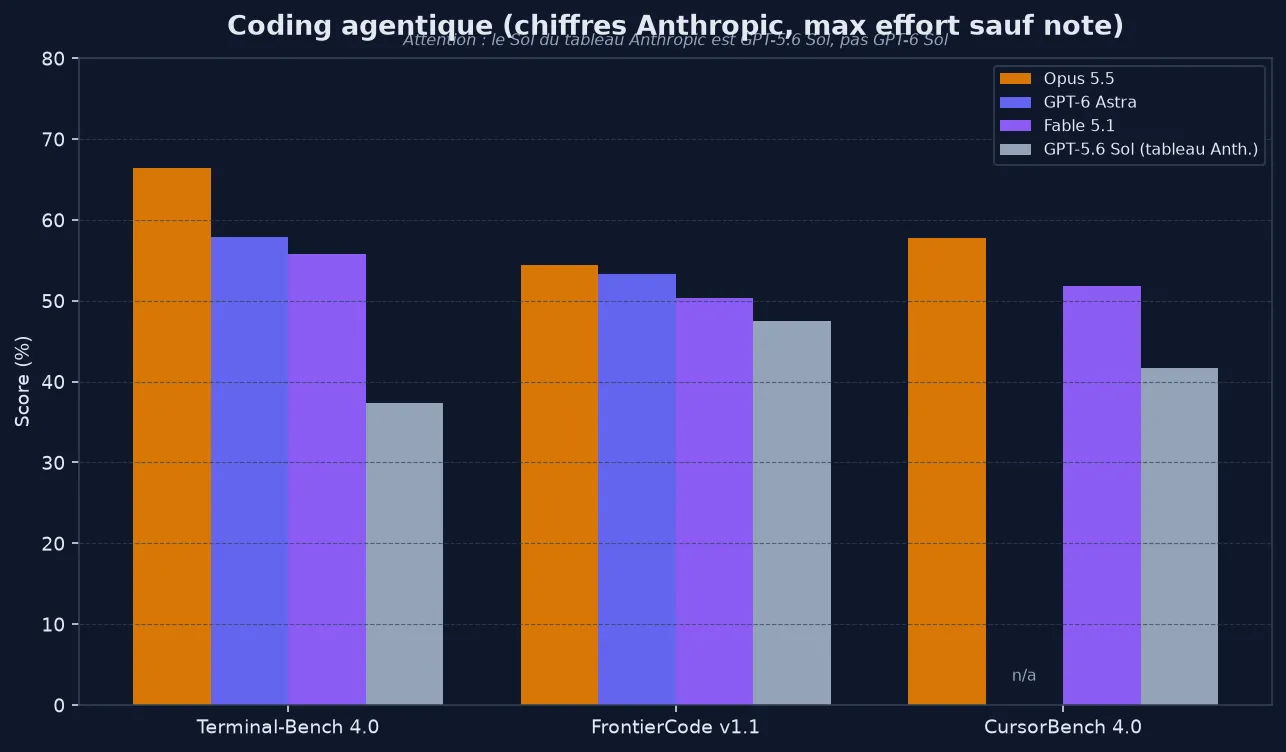
Anthropic ajoute qu’à effort défaut (medium), Opus 5.5 bat Astra sur FrontierCode pour ~20 % du coût/tâche, matche Astra sur Terminal-Bench pour ~40 % du coût, et bat le top GPT-5.6 Sol sur CursorBench d’environ 11 points pour ~un tiers du coût. Ces ratios coût/tâche sont vendor. Sur OSWorld 2.0, Anthropic affiche Opus 5.5 à 81,8 % partial, loin du 60,5 % Sol xhigh (offline) d’OpenAI : les setups ne sont probablement pas alignés, il faut le dire avant de conclure.
Agents coding et knowledge work pour un budget API
Quatre lectures raisonnables pour un acheteur, sans inventer de score manquant :
- Prix unitaire : Sol GPT-6 est environ 2× moins cher qu’Opus 5.5 en input/output. Cache read à égalité. Cache write et surcharge >272 k à surveiller côté Sol.
- Proxy OpenAI (Sol vs Opus 5 / Fable) : Sol tient très bien la courbe coût / score sur AutomationBench, DeepSWE et OSWorld offline, souvent à −60 % à −80 % de coût/tâche face à Opus 5 ou Fable.
- Grille Anthropic (Opus 5.5 vs GPT-5.6 Sol / Astra) : Opus 5.5 domine Terminal-Bench, CursorBench, FrontierCode et GDPval dans ce tableau. Le Sol cité est l’ancienne génération. Astra reste le rival OpenAI le plus proche sur plusieurs lignes.
- Produit et garde-fous : Sol = Work / Codex / API, thinking configurable (none → max). Opus 5.5 = toutes plateformes, thinking adaptatif always-on, safeguards cyber/bio type Fable (re-routage possible), preserved thinking anti-distillation pour comptes API post-31 août 2026. Zero data retention annoncé côté Opus.
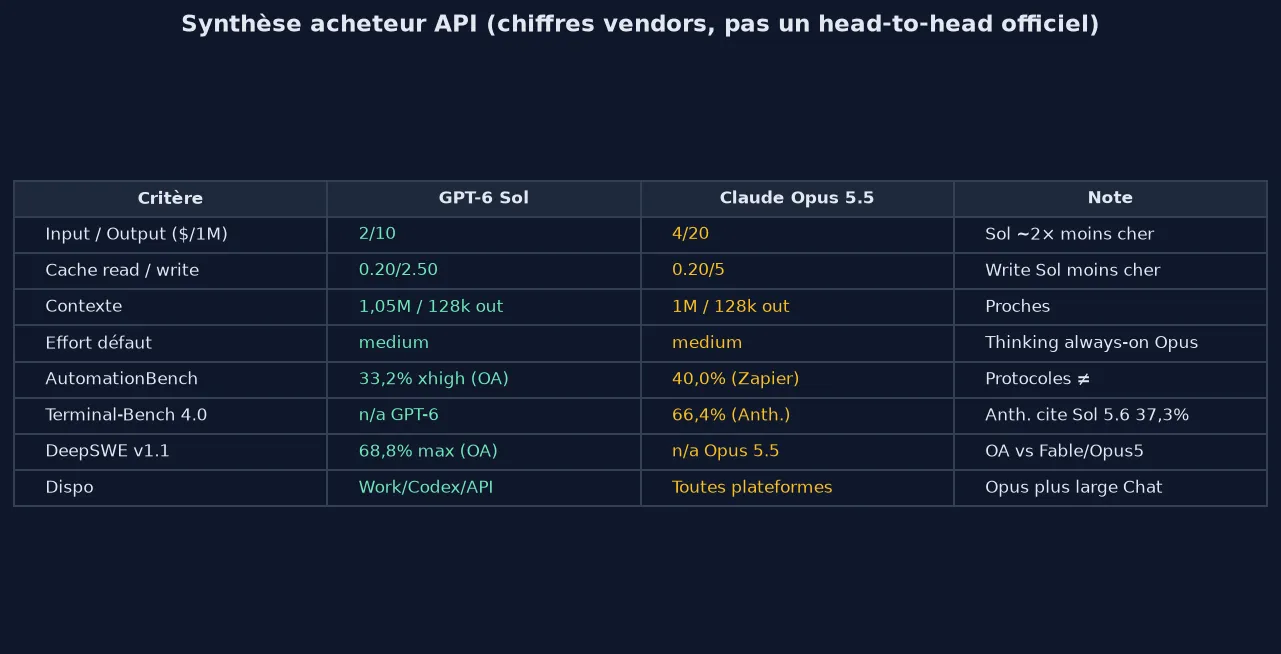
En pratique : si votre flotte d’agents coding / knowledge work est surtout sensible au coût token et que vos evals internes ressemblent aux protocoles OpenAI (AutomationBench, DeepSWE, OSWorld offline), Sol GPT-6 devient le challenger prix du jour. Si vous visez les barèmes où Anthropic place Opus 5.5 en tête (Terminal-Bench 4.0, CursorBench, GDPval) et que vous acceptez le ticket 4 $ / 20 $ plus les garde-fous, Opus 5.5 reste le candidat « quotidien » Anthropic face à Fable. Dans les deux cas, lancez vos propres jeux de tests : les efforts (medium / high / xhigh / max), les harness et les fallbacks changent les classements.
Repère optionnel du 21 septembre : notre comparatif Grok 4.7 (2 $ / 6 $ sous 200k). Sources primaires : Introducing GPT-6 Sol and Luna, docs gpt-6-sol, Claude Opus 5.5, Models overview Anthropic.
