Mistral Large 4 : les poids du « Chonk » sont en ligne, avec une licence qui fait payer les hébergeurs d’API
Mistral AI a publié jeudi 29 octobre les poids de Mistral Large 4, son modèle phare surnommé « Le Chonk ». Le fichier est téléchargeable sur Hugging Face depuis le billet officiel de la start-up parisienne, avec deux jours de retard sur la date du 27 octobre avancée auprès de la presse lors de la préversion publique du 6 octobre. Il ne s’agit pas exactement du modèle de la préversion : Mistral indique avoir poursuivi l’apprentissage par renforcement pendant trois semaines.
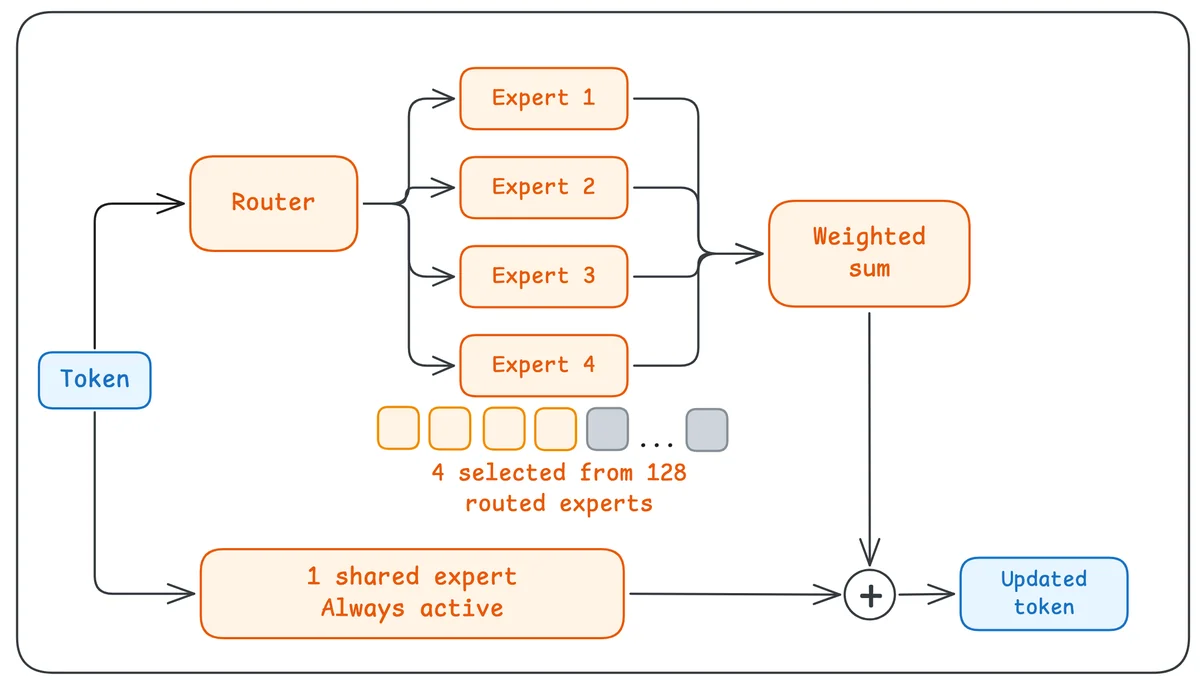
Sur le papier, la fiche ne bouge pas. Mistral Large 4 est un modèle mixture-of-experts d’environ 1 000 milliards de paramètres, dont 49 milliards actifs par token (52 milliards en comptant les couches d’embedding et de sortie), avec une fenêtre de contexte d’un million de tokens. Il accepte du texte et des images en entrée et répond en texte. Il a été entraîné de zéro sur 3 800 GPU Nvidia Grace Blackwell dans les centres de données européens de Mistral. Deux variantes officielles sont proposées, en FP8 et en NVFP4, et des versions GGUF ont été produites par Unsloth et par l’équipe de llama.cpp, précise Hugging Face.
Terminal-Bench : 41 % contre 28 % en préversion
Les trois semaines d’entraînement supplémentaire ont surtout porté sur le code. Selon Mistral, le score sur Terminal-Bench 4.0 passe à 41 %, soit 13 points de plus qu’en préversion, avec 30 % de tokens de sortie en moins. Sur l’indice Coding Agent d’Artificial Analysis, le modèle atteint 48 %, à égalité avec GLM-5.3, en consommant en moyenne 47 % de tokens de moins par tâche. Sur le test privé FrontierCode 2.0 de Cognition, il mène avec 19,7 %. Dans les comparaisons à l’aveugle de Surge, les évaluateurs l’ont préféré à GLM-5.3, Kimi K3 et DeepSeek V4.1 Flash, seul Claude Opus 5.5 restant devant.
Côté cybersécurité, argument numéro un de l’éditeur, Mistral Large 4 obtient 51 % sur l’Artificial Analysis Cyber Index et refuse en moyenne 96,6 % des requêtes cyber malveillantes, le meilleur taux mesuré parmi les modèles ouverts selon Mistral. L’éditeur reconnaît toutefois avoir observé, en surveillant le trafic réel depuis la préversion, un « potentiel » d’aide à de véritables attaques, et dit renforcer ses garde-fous en conséquence. Une variante spécialisée pour le test d’intrusion reste réservée à des partenaires triés sur le volet, dont Orange Cyberdefense. Tous ces chiffres sont fournis par Mistral, le rapport technique complet étant annoncé « bientôt ».
Le modèle propose désormais trois niveaux de raisonnement (bas, moyen, élevé), le niveau élevé étant celui par défaut. Le raisonnement ne peut pas être désactivé. Via l’API, le tarif passe à 0,70 dollar par million de tokens en entrée, 0,07 dollar en entrée mise en cache et 2,10 dollars en sortie.
Une licence MIT, avec un péage pour les hébergeurs d’API
Les poids sont distribués sous une nouvelle licence, la Mistral Ecosystem Open-Weight License, présentée comme une version modifiée de la licence MIT. Usage, modification, réentraînement, redistribution et exploitation commerciale sont libres, avec une condition : toute entreprise qui opère une activité de « Model as a Service » doit signer une licence commerciale séparée avec Mistral avant d’utiliser le modèle ou ses dérivés à des fins commerciales.
Le texte définit ce cas comme le fait de donner à un tiers un accès au modèle pour l’inférence ou le post-entraînement, par API ou point d’accès hébergé, avec un contrôle réel sur les entrées, les paramètres ou les données. Sont exclus les produits finis qui intègrent le modèle dans des fonctions précises, le simple relais de requêtes vers un modèle hébergé ailleurs, l’usage interne et l’usage via les produits officiels de Mistral. Concrètement, une banque ou une administration peut l’héberger pour ses propres besoins sans rien demander, mais un fournisseur cloud concurrent de l’API de Mistral devra négocier.
512 Go de mémoire unifiée pour le faire tourner chez soi
Le support est assuré dès le premier jour dans Transformers, vLLM et llama.cpp. Le modèle reste hors de portée d’un PC de joueur. D’après les essais de Hugging Face, les quantifications 2 bits tiennent sur un seul Mac à puce Apple Silicon Ultra doté de 512 Go de mémoire unifiée : en Q2_K sur un M3 Ultra, l’équipe a mesuré environ 90 tokens par seconde en lecture du prompt et 15 tokens par seconde en génération. Les autres formats demandent une inférence répartie sur plusieurs cartes. Sur quatre RTX 6000 Pro, la version NVFP4 génère environ 10 tokens par seconde avec 32 000 tokens de contexte. La recette prête à déployer de Hugging Face s’appuie sur huit GPU Nvidia H200.
Pour ceux qui ne veulent pas héberger le modèle, Mistral Large 4 est disponible dans Mistral Studio, via l’API, sur OpenRouter, en conteneur Nvidia NIM et sur Microsoft Foundry, Microsoft se présentant comme le premier fournisseur cloud à le proposer. Mistral annonce que ce modèle servira de base à une nouvelle génération de modèles spécialisés.
Sources : Mistral AI, Hugging Face, licence du modèle.
Thomas Duvillard Site web de Thomas Duvillard
Thomas Duvillard est rédacteur en chef de Geek Actu. Il couvre les jeux vidéo, le high-tech et la pop culture, tests et analyses à l’appui.