textGrain : OpenAI va filigraner les textes de ChatGPT en Europe, et seulement là
Les textes de ChatGPT vont porter une signature que personne ne voit. OpenAI a annoncé lundi 5 octobre l’arrivée de textGrain, un filigrane invisible glissé dans les réponses générées par ChatGPT et Codex. Le déploiement se fera « dans les prochaines semaines », pour les utilisateurs éligibles de l’Union européenne, tous abonnements confondus, et seulement pour eux. L’éditeur détaille sa démarche dans un billet consacré aux règles européennes de provenance.
La raison est réglementaire. L’article 50 de l’AI Act, applicable depuis le 2 août 2026, impose aux fournisseurs d’IA générative de rendre les contenus produits identifiables par une machine. OpenAI fait partie des signataires du code de bonnes pratiques européen sur la transparence des contenus générés par IA, qui encadre la mise en œuvre de cette obligation. Selon Les Numériques, un manquement expose à une amende pouvant atteindre 15 millions d’euros ou 3 % du chiffre d’affaires mondial.
Hors d’Europe, rien ne change par défaut. OpenAI précise qu’il ne fait pas du filigrane un réglage mondial « au lancement », afin d’apprendre de l’usage réel. Côté API, les clients du monde entier peuvent depuis lundi l’activer sur certains modèles, mais l’option reste désactivée par défaut. Des partenaires cloud doivent suivre dans les prochaines semaines. Anthropic a fait l’inverse : son filigrane, une variante de SynthID-Text de Google DeepMind, s’applique partout depuis le 2 août, l’éditeur de Claude expliquant ne pas disposer d’un moyen fiable de le limiter à une région.
Un motif caché dans le choix des mots
textGrain n’ajoute ni caractère caché, ni espace invisible, ni ponctuation étrange. Le système ajuste la façon dont le modèle tire au hasard entre plusieurs mots possibles. Sur un passage entier, ces choix dessinent un motif statistique que seul un détecteur muni de la clé secrète peut repérer. Le rapport technique publié le même jour, cosigné par des chercheurs de l’université de Pennsylvanie, de Yale et d’OpenAI, décrit la méthode. OpenAI annonce une version open source.
D’après l’éditeur, textGrain égale ou dépasse SynthID pour le texte dans ses évaluations. Le marquage ne dégrade pas non plus les résultats d’Astra, son dernier modèle de pointe : 49,76 points à l’indice d’Artificial Analysis avec filigrane, contre 49,57 sans, et 71,68 % contre 72,80 % sur DeepSWE v1.1.
Un mot sur quatre remplacé, et le signal s’efface
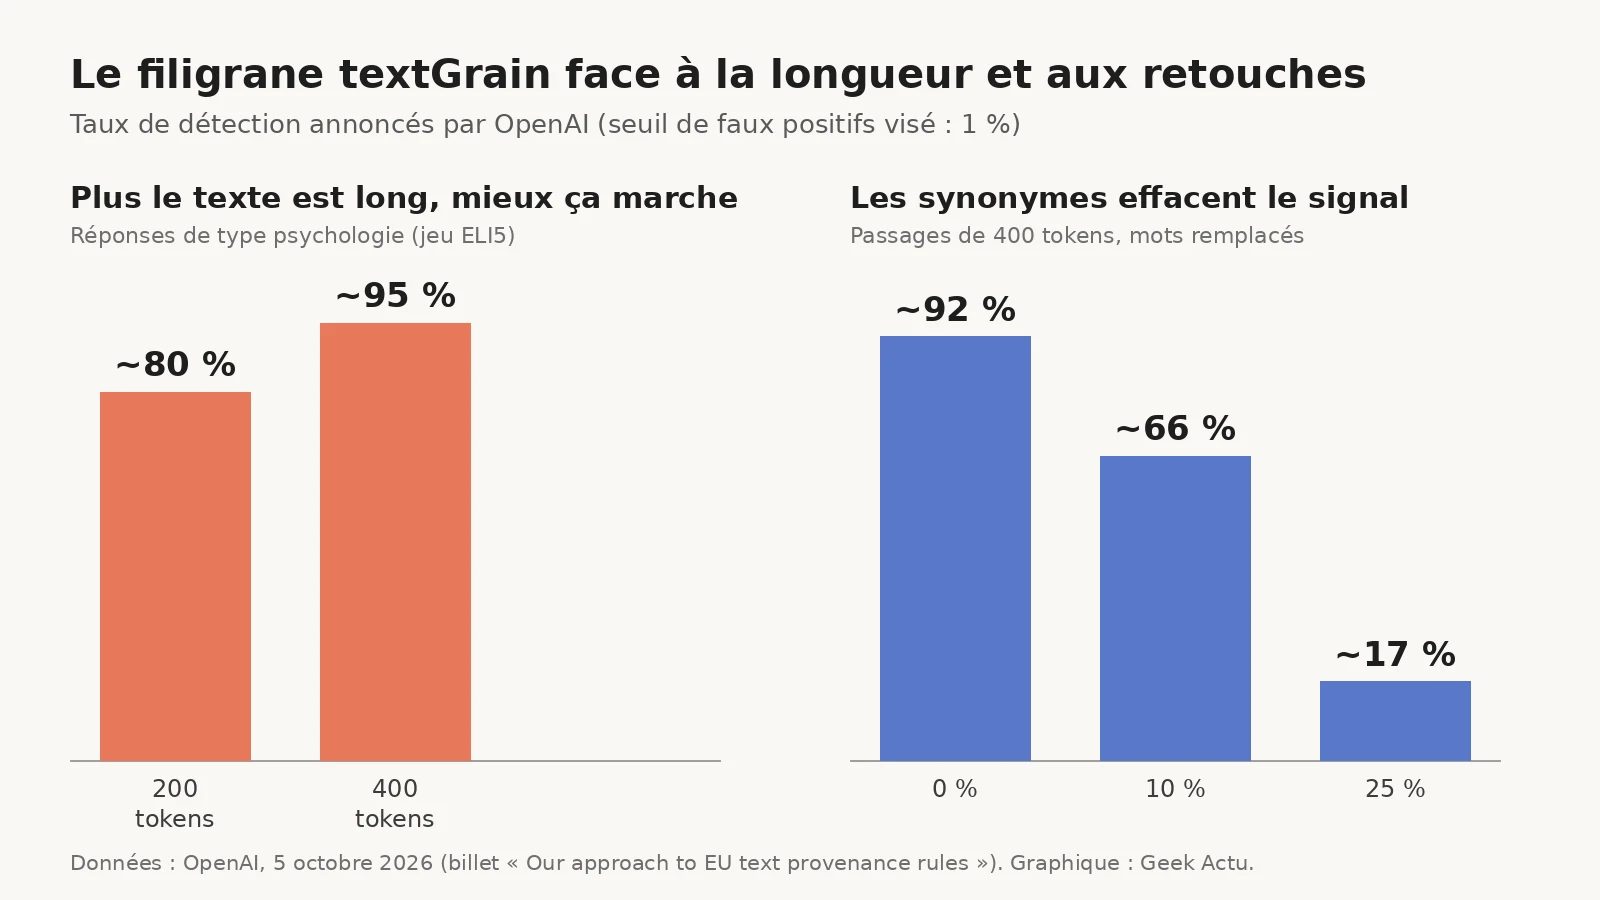
OpenAI publie aussi les limites, chiffres à l’appui. Avec un taux de faux positifs visé de 1 %, le détecteur retrouve le filigrane dans environ 80 % des passages de 200 tokens et 95 % des passages de 400 tokens sur des réponses de type psychologie. Sur des contenus mathématiques, où le choix des mots est plus contraint, la détection est « nettement plus faible ». Les retouches font le reste : sur des passages de 400 tokens, remplacer 10 % des mots par des synonymes fait tomber la détection d’environ 92 % à 66 %, et 25 % la ramène à 17 %. Une traduction peut aussi empêcher une détection fiable.
D’où un détecteur sous clé. Les chercheurs et organismes experts peuvent candidater depuis lundi, avec un accès accordé au cas par cas. L’outil indiquera seulement s’il repère un filigrane OpenAI. Il n’identifie pas l’utilisateur et ne révèle ni prompt ni conversation, assure l’éditeur, qui écarte une ouverture au public en raison du risque de faux positifs et de filigranes manqués.
OpenAI énumère d’ailleurs ce que le filigrane ne dit pas : la part de travail humain, la propriété du texte, sa licéité ou son exactitude. L’absence de marque ne prouve pas non plus qu’un humain a écrit le texte. Celui-ci peut être trop court, retouché, traduit, antérieur au dispositif, ou produit par un autre outil. Pour les images et l’audio, déjà marqués par SynthID et Content Credentials, la vérification publique via openai.com/verify reste ouverte.
Le sujet n’est pas neuf chez OpenAI. Selon le Wall Street Journal, cité par Les Numériques, l’entreprise disposait d’un prototype dès 2023 sans jamais le déployer, une enquête interne indiquant que près de 30 % des abonnés réduiraient leur usage de ChatGPT si leurs textes étaient filigranés. Il a fallu une loi européenne pour le sortir du tiroir, et encore : seulement pour l’Europe, et avec un détecteur que presque personne ne pourra utiliser pour l’instant.
Thomas Duvillard Site web de Thomas Duvillard
Thomas Duvillard est rédacteur en chef de Geek Actu. Il couvre les jeux vidéo, le high-tech et la pop culture, tests et analyses à l’appui.